1. 监控要检查真正的业务入口#
Ping 通只说明某种网络探测有应答,不能证明网站、登录和数据库都正常。网站监控优先检查实际 HTTPS 地址、预期状态码和关键内容,必要时增加证书到期与业务健康接口。
监控程序最好运行在被监控服务器之外,否则机器整体离线时它也无法发通知。面向不同地区的服务,可增加不同网络来源,区分源站故障与单条线路异常。
2. 用 Uptime Kuma 建立一个小型监控实例#
先准备 Docker、独立持久卷和受控管理入口。官方当前提供 2 系列镜像,正式部署应记录具体版本或摘要。下面仅映射到主机本地 3001:
docker run -d --restart=unless-stopped --name uptime-kuma -p 127.0.0.1:3001:3001 -v uptime-kuma:/app/data louislam/uptime-kuma:2
docker logs --tail 50 uptime-kuma
通过 SSH 隧道或已有 HTTPS 反向代理访问,创建管理员后再使用。数据卷保存监控配置和历史,更新容器时不能随意删除。
3. 添加 HTTPS 检查并设置合理阈值#
点击 Add New Monitor,选择 HTTP(s),填写自己的网站名称和完整 URL,设置检查间隔、超时与重试。先使用能承受的小频率,例如一分钟一次,再按业务需要调整。
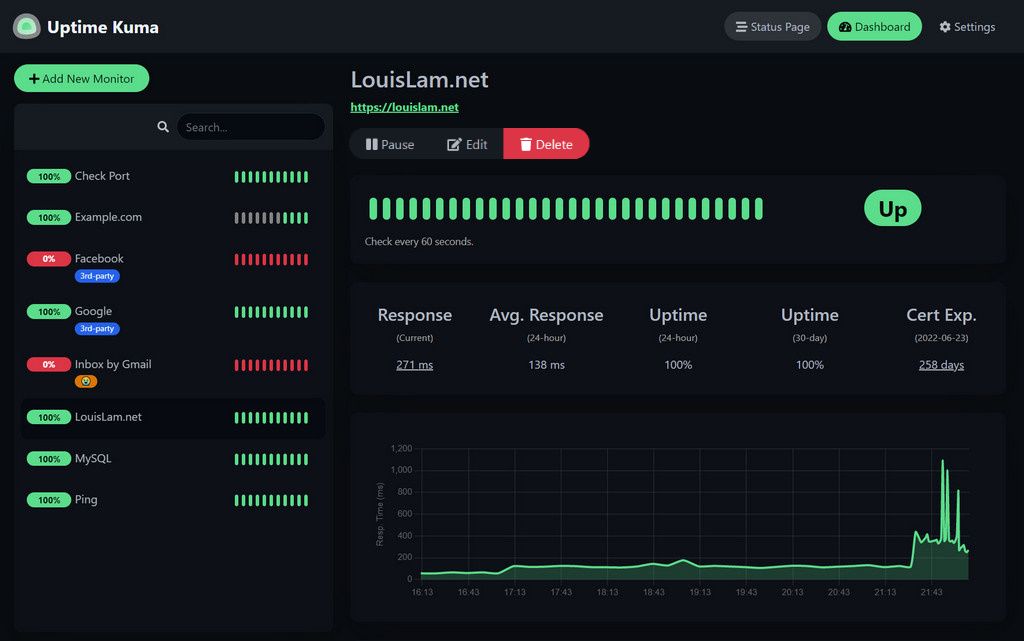
如果首页即使故障也返回自定义 200 错误页,可增加内容关键字或专门健康接口。健康接口要反映关键依赖,同时避免公开数据库凭据、内部路径或详细错误堆栈。
4. 真正测试一次告警和恢复#
配置自己控制的通知渠道,先用测试功能确认能收到,再对一个独立测试地址模拟故障,验证经过重试后触发通知,恢复后也发送恢复信息。不要为了测试直接停止正式网站。
给告警写清楚站点、时间、失败原因和检查位置,避免只有“Down”。设置适当重试与维护窗口,减少短暂波动刷屏;但阈值过宽也会延迟发现,按业务容忍度选择。
5. 状态页与监控后台分开#
公开状态页只展示适合用户查看的服务和事件,不暴露管理入口、私人 IP 或内部组件详情。Uptime Kuma 可展示状态页;cState 等静态状态页适合发布事件说明,但需要自己的事件更新或集成流程,不能仅部署页面就宣称自动监控。
第三方监控服务如 UptimeRobot 的免费额度、检查间隔和通知范围会变化,使用前查看当前计划。自建 HTML5 测速页面测的是访问者到测试服务器的吞吐,不替代可用性监控,还会产生真实流量。
6. 维护监控本身的可靠性#
定期检查监控任务是否还在运行、通知令牌是否失效、磁盘是否增长、证书是否自动续期。备份配置与历史数据,更新后验证同一个测试监控能告警和恢复。
主机 CPU/内存等资源指标可用进程监控或Prometheus补充。对用户最有用的结果仍是“服务能否完成预期操作”,不是单纯一排绿灯。
完成后检查
监控应能回答“服务是否可用、从何时开始失败、谁会收到通知”。定期验证告警链路。